NVIDIA бросила вызов главному проклятию квантовых вычислений: поиск ошибок ускорился в 13 000 раз
12 недель превратились в 45 минут.
NVIDIA разработала алгоритм, который помогает находить ошибки в квантовых вычислениях до 13 000 раз быстрее одного из существующих методов. При обработке большого набора экспериментальных данных разработчики сократили расчёты с 12 недель до 45 минут. Новинка позволит учёным быстрее проверять способы защиты квантовых компьютеров от сбоев, которые пока мешают использовать такие машины для сложных и продолжительных вычислений.
Разработчики назвали новый алгоритм TCBP-JOBS. Программа использует небольшую нейросеть и графические ускорители NVIDIA, чтобы быстро находить наиболее вероятные ошибки в квантовых схемах. По результатам испытаний, точность поиска оказалась сопоставима с одним из лучших существующих алгоритмов, а в отдельных тестах новинка даже превзошла конкурента.
Главная проблема квантовых компьютеров заключается в чрезвычайной чувствительности кубитов, которые хранят и обрабатывают информацию. В отличие от обычных битов, принимающих значения 0 или 1, кубиты могут находиться в сочетании двух состояний. Однако малейшие помехи, неточные управляющие сигналы и взаимодействие с окружающей средой способны нарушить квантовое состояние и испортить результат вычислений. Чем больше операций выполняет процессор, тем выше вероятность накопления ошибок.
Для защиты информации инженеры объединяют несколько физических кубитов в один логический и регулярно проверяют специальные контрольные сигналы. По результатам измерений обычный компьютер пытается восстановить картину произошедшего и определить, какие ошибки нужно исправить. Задача напоминает поиск опечаток в тексте, только проверяющему приходится разбирать множество возможных комбинаций ошибок и учитывать законы квантовой физики. Чем сложнее вычисления, тем больше времени требует поиск правильного решения.
NVIDIA предложила ускорить самый трудоёмкий этап. Нейросеть изучает, как меняются оценки вероятности ошибок при последовательных проверках, и помогает определить наиболее подозрительные участки. Затем графический процессор одновременно перебирает несколько вариантов исправления вместо того, чтобы проверять кандидатов по очереди. Алгоритм выбирает наиболее убедительный результат, заметно сокращая время вычислений.
Разницу хорошо показывают испытания на 24,2 млн смоделированных квантовых схем. По оценке NVIDIA, прежнему методу Tesseract потребовалось бы около 12 недель даже при распределении работы между 64 процессорными ядрами. TCBP-JOBS справился примерно за 45 минут на одном ускорителе GB200. В отдельном испытании время поиска ошибки сократилось с десятков секунд до нескольких миллисекунд, что и позволило получить максимальное ускорение более чем в 13 000 раз.
При этом высокая скорость не заставила разработчиков полностью пожертвовать точностью. Специалисты проверили несколько способов защиты квантовой информации, включая схемы с различным количеством физических кубитов. В большинстве испытаний TCBP-JOBS находил ошибки примерно с той же точностью, что и Tesseract. На самых крупных проверенных схемах новый метод в отдельных условиях оставлял до 4,5 раза меньше неисправленных ошибок.
Алгоритм также способен подстраиваться под особенности квантового оборудования. Нейросеть анализирует результаты контрольных измерений и уточняет вероятность разных сбоев, даже когда разработчики заранее не знают точных характеристик помех. Благодаря этому инженеры смогут проверять способы исправления ошибок, не полагаясь исключительно на предварительные расчёты.
Однако TCBP-JOBS пока нельзя считать универсальным решением. Когда физические ошибки встречаются особенно редко, Tesseract в некоторых испытаниях сохранял преимущество по точности. Кроме того, NVIDIA сравнивала вычисления на графическом ускорителе с работой обычных процессорных ядер. Поэтому заявленные 13 000 раз характеризуют конкретные условия испытаний, а не ускорение самих квантовых компьютеров.
Разработчики также проверили, насколько быстро алгоритм сможет обрабатывать ошибки во время работы квантового процессора. В отдельных испытаниях поиск занимал около четырёх миллисекунд. Для некоторых квантовых систем задержка приемлема, но многие современные процессоры выполняют операции значительно быстрее и требуют почти мгновенного исправления сбоев. Для практического применения придётся учитывать не только скорость расчётов, но и время передачи данных между квантовым процессором и обычным компьютером.
NVIDIA уже добавила TCBP-JOBS в библиотеку CUDA-Q QEC 0.9.0. Учёные смогут использовать алгоритм для моделирования квантовых схем, сравнения способов защиты информации и поиска более экономных конструкций, которым требуется меньше физических кубитов. Пока разработка прежде всего ускоряет исследования, но сокращение многонедельных расчётов до десятков минут может помочь быстрее приблизиться к созданию квантовых компьютеров, способных надёжно решать практические задачи.
Источник
Для просмотра ссылки Войди или Зарегистрируйся
AMD захватила 40 % рейтинга мощнейших суперкомпьютеров TOP500 — новый Lux дебютировал на 14-м месте
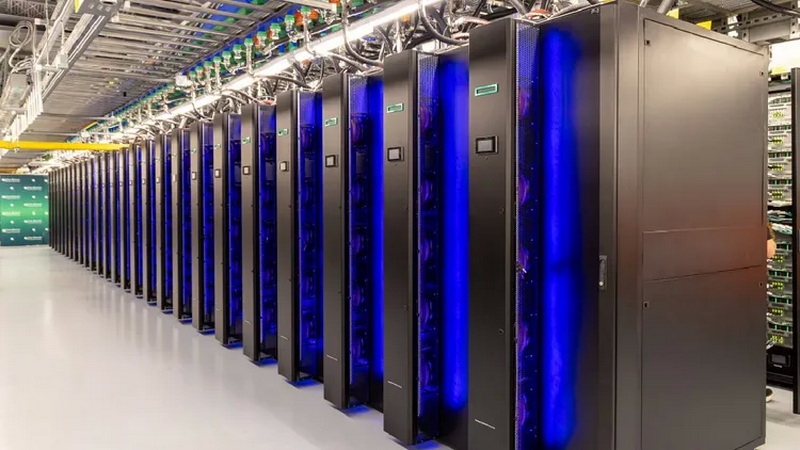
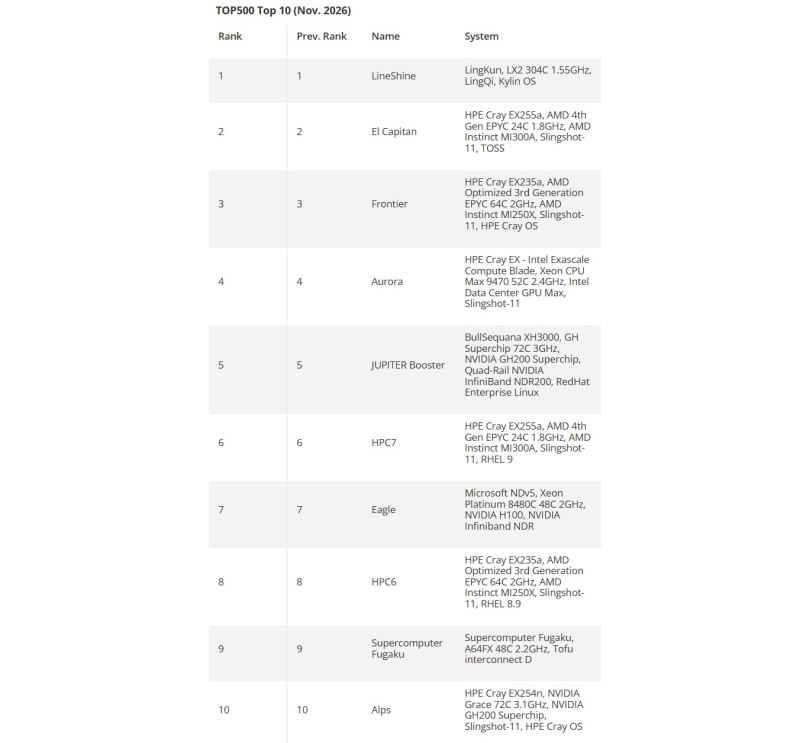
К началу конференции SC26 вышел обновлённый рейтинг 500 самых мощных суперкомпьютеров мира TOP500. Согласно свежим данным, доля систем на базе технологий AMD в списке достигла 40 % — это на 14 п.п. больше, чем в 2025 году. Теперь в рейтинг включены 202 системы с компонентами AMD (годом ранее их было 177). Главным новичком рейтинга стал суперкомпьютер Lux, созданный AMD совместно с Министерством энергетики США (DOE) и занявший 14-ю строчку.
Источник изображения: Oak Ridge National Laboratory
В первой десятке позиции AMD остаются стабильными. Китайский суперкомпьютер LineShine, дебютировавший в июне, по-прежнему удерживает первое место. На второй позиции находится система El Capitan, работающая на чипах AMD. За ней следуют Frontier (3-е место), HPC7 (6-е место) и HPC6 (8-е место) — состав первой десятки остался таким же, как и в предыдущей версии рейтинга TOP500.
Суперкомпьютер Lux был анонсирован чуть более года назад в рамках сделки на сумму $1 млрд между Министерством энергетики США и AMD, предусматривающей создание двух вычислительных систем. Он был построен компанией HPE в рамках правительственной программы Genesis Mission. Суперкомпьютер размещен в Окриджском центре высокопроизводительных вычислений (OLCF) при Окриджской национальной лаборатории — там же, где находится система Frontier.
В составе Lux используется более 4000 графических процессоров Instinct MI355X, распределённых по более чем 500 узлам, размещённым в серверах HPE ProLiant Compute XD685. При выполнении высокопроизводительных вычислений (HPC) с использованием вычислений двойной точности (FP64) система демонстрирует производительность 317 петафлопс. В задачах обучения нейросетей пиковая производительность достигает 20 эксафлопс (в формате FP8), а в задачах инференса (вывода) — 40 эксафлопс (в формате FP4). Благодаря наличию 288 Гбайт памяти HBM3E на каждый графический процессор суммарный объём памяти всей системы составляет 1,1 петабайта. Система построена на базе процессоров AMD EPYC (точная модель и поколение не уточняются) и сетевых решений AMD Pensando.
Источник изображения: Tom's Hardware
Вычислительный ресурс машины оценивается в 3,5 млн узло-часов в год, половина из которых зарезервирована для исследований в рамках Genesis Mission. Программа была учреждена исполнительным указом в ноябре 2025 года и предусматривает обучение научных базовых моделей (scientific foundation models) на федеральных наборах данных, а также создание «ИИ-агентов для проверки новых гипотез, автоматизации исследовательских процессов и ускорения научных прорывов».
Lux — первый специализированный суперкомпьютер для Genesis Mission. Однако он дополняет уже существующие вычислительные системы, которые также частично используются для научных исследований. К ним относится, например, суперкомпьютер Aurora (на базе технологий Intel) в Аргоннской национальной лаборатории, занявший четвёртое место в последнем рейтинге TOP500.
Суперкомпьютер Lux предназначен прежде всего для исследований в области ИИ и не является преемником Frontier. В 2028 году ожидается запуск суперкомпьютера нового поколения экзафлопсного уровня — Discovery. Он также разрабатывается совместными усилиями Министерства энергетики США (DOE), компаний AMD и HPE.
Источник
Для просмотра ссылки Войди или Зарегистрируйся
Nvidia представила настольный суперкомпьютер DGX Spark HPC из четырёх мини-ПК
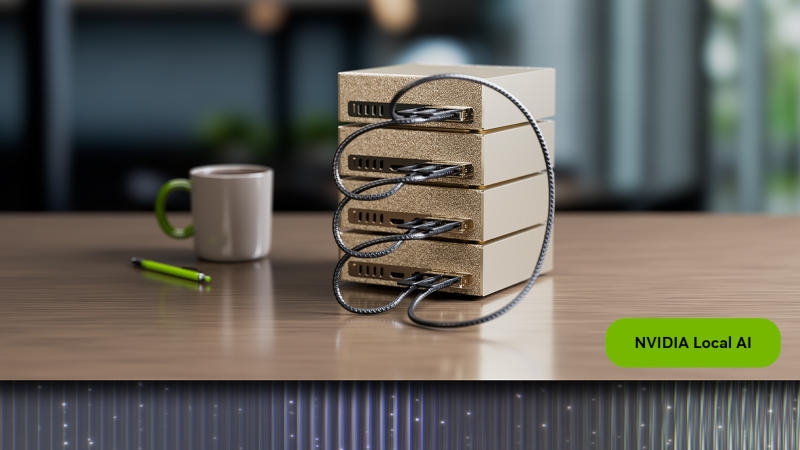
Nvidia анонсировала DGX Spark HPC Developer Kit — так называемый комплект разработчика, который включает четыре мини-ПК DGX Spark на платформе GB10 Grace Blackwell Superchip, соединённых по кольцевой топологии. Он ориентирован на исследователей, ученых и разработчиков, которые получат возможность запускать многоузловые научные задачи, модели и агентов искусственного интеллекта прямо на рабочем столе, не дожидаясь очереди на доступ к большому GPU-кластеру.
Источник изображения: nvidia.com
Система масштабируется от одного до четырёх узлов — они соединяются с помощью сетевых адаптеров Nvidia ConnectX-7, избавляя от необходимости покупать и настраивать отдельный сетевой коммутатор. Конфигурация из четырёх узлов обеспечивает 512 Гбайт общей памяти и 20 Тбайт дискового пространства NVMe. Используя формат NVFP4, на таком кластере можно развёртывать модели размером до 700 млрд параметров, например DeepSeek V4.1.
Напомним, каждая система DGX Spark оснащена суперчипом Nvidia GB10 Grace Blackwell, в котором объединены графический процессор Blackwell и 20-ядерный процессор Arm. Процессор включает 10 высокопроизводительных ядер Cortex-X925, работающих на частоте до 4 ГГц, и 10 энергоэффективных ядер Cortex-A725 — до 2,8 ГГц. Графический процессор Blackwell содержит 6144 ядра CUDA и обеспечивает производительность FP4 до 1 Пфлопс. Система использует 128 Гбайт когерентной унифицированной памяти LPDDR5X с 256-битным интерфейсом и пропускной способностью 273 Гбайт/с. Энергопотреболением (TDP) чипа GB10 составляет 140 Вт.
В ближайшем будущем компания выпустит руководство по использованию Nvidia HPC SDK, которое позволит задействовать в кластере DGX Spark компиляторы C, C++ и Fortran с поддержкой ускорения на GPU, библиотеки и инструменты интерфейса передачи сообщений (MPI) — те же средства разработки применяются на мощных суперкомпьютерах Nvidia.
Инструментарий позволяет производить научное моделирование, запускать модели и ИИ-агентов прямо на рабочем столе. Продемонстрирована работа таких приложений как LAMMPS с использованием библиотеки Kokkos для моделирования материалов и NAMD для задач молекулярной динамики. Платформа эффективна для работы с такими специализированными инструментами как GROMACS (молекулярная динамика), OpenFOAM (гидродинамика), WRF (моделирование погодных условий); поддерживаются микросервисы Nvidia NIM, в том числе OpenFold3 и Boltz-2 для прогнозирования биомолекулярных структур; можно производить дообучение Nemotron 3.5 Super VL, адаптируя модель для задач в области биомедицинских и химических наук.
Компания привела несколько примеров практического применения Nvidia DGX Spark. Компания Kvantify использовала систему для квантово-химических расчётов с моделированием квантовых систем с 70 кубитами и 975 логическими операциями. CYRAN AI это оборудование помогло ускорить обработку спутниковых снимков формата JPEG 2000. OpenFold использовала DGX Spark для дообучения моделей предсказания структуры белков и их взаимодействия с лекарственными веществами. Эти системы также применялись для прогнозирования свойств бактерий по последовательностям генома; а также для запуска и дообучения модели размером 12 млрд параметров.
Источник
Для просмотра ссылки Войди или Зарегистрируйся