Гонка ИИ - от уровня "рассуждающего ИИ" до "суперинтеллекта" ( 3 ий этап )

XUC

второе пришествие
Регистрация
3 Сен 2006
Сообщения
877
Реакции
577

Китай сравняется с США в ИИ-гонке уже к 2030 году — а в отдельных сферах даже обгонит​


США могут потерять единоличное лидерство в сфере искусственного интеллекта: к 2030 году Китай способен сравняться с ними по влиянию на мировой ИИ-рынок и выйти вперёд в ряде ключевых технологических отраслей. По прогнозу Bloomberg Intelligence, Китай возглавит восемь из 17 стратегически важных направлений, включая разработку больших языковых моделей. При этом в производстве передовых чипов и других компонентов для ИИ американские компании сохранят преимущество.
 Источник изображения: Steve A Johnson/unsplash.com

Источник изображения: Steve A Johnson/unsplash.com​

Согласно исследованию аналитиков, Китай имеет все шансы стать мировым лидером в области больших языковых моделей (LLM), которые лежат в основе систем искусственного интеллекта, а также сохранять конкурентоспособность во всех остальных стратегически важных технологических секторах.
Согласно прогнозам Bloomberg Intelligence, к 2030 году Китай опередит другие страны в восьми из 17 ключевых отраслей, включая разработку LLM. В других критически важных для развития ИИ сегментах — например, в производстве аппаратного обеспечения (от чипов до компонентов оптических сетей) — китайские компании пока отстают, однако через несколько лет они смогут составить достойную конкуренцию нынешним лидерам, отметили аналитики.


«США и Китай движутся к совместному технологическому лидерству в сфере ИИ, при этом ни одна из сторон, вероятно, не добьётся абсолютного превосходства», — сообщается в исследовании. По мнению аналитиков, американские ИИ-модели могут сохранить небольшое преимущество на переднем крае технологий, в то время как компетенции Китая в области оптимизации программного обеспечения создают благоприятные условия для внедрения более доступных по стоимости решений на базе ИИ.
Также ожидается, что Китай сократит отставание в сфере полупроводниковых технологий, хотя и не достигнет полной самодостаточности.
Согласно исследованию Bloomberg Intelligence, Китай выйдет в мировые лидеры во всех трёх категориях, связанных с новой энергетикой (включая электромобили и системы хранения энергии), а также в сфере биофармацевтического производства. Поднебесная империя уже лидирует по выпуску человекоподобных роботов и в ряде направлений судостроения, а по объёму расходов на исследования и разработки сравнялась с Соединёнными Штатами.
Что касается ИИ, то прогресс в этом направлении сдерживается тем, что китайские компании, впрочем, как и ИИ-стартапы в других странах, пока не нашли эффективных способов монетизации своих инноваций. По оценке Bloomberg Intelligence, они по-прежнему участвуют в своего рода гонке на выживание со снижением цен на свои услуги до предела, и получение прибыли останется труднодостижимой целью, пока компании не перейдут к более рациональному подходу к ценообразованию.

Кроме того, противоречия во взаимоотношениях с США, Европой и другими торговыми партнёрами будут и дальше серьёзным препятствием для дальнейшего развития китайских технологических гигантов: доступ к прибыльным рынкам для них может быть закрыт, а экспортные ограничения могут лишить доступа к передовым компонентам. Но, как считают аналитики, эти ограничения, скорее, приведут к изменению географии промышленной экспансии Китая, чем к её полной остановке.

Источник Для просмотра ссылки Войди или Зарегистрируйся
 

Skynet уже близко? Anthropic предупредила, что близка к созданию саморазвивающегося ИИ​

Claude может приблизить появление ИИ, способного самостоятельно совершенствовать себя​


Anthropic предупредила инвесторов, что может вскоре приблизиться к созданию саморазвивающегося ИИ. В обновлённой документации к IPO компания впервые подробно описала риск так называемого рекурсивного самоулучшения (Recursive Self-Improvement, RSI) — процесса, при котором искусственный интеллект помогает создавать всё более совершенные модели, ускоряя тем самым собственный прогресс.
Для просмотра ссылки Войди или Зарегистрируйся
Источник изображения: ИИ Gemini

RSI считается одним из возможных переломных моментов в развитии ИИ. Сторонники технологии видят в ней путь к резкому росту производительности, научным открытиям и автоматизации исследований. Критики опасаются, что системы, способные самостоятельно совершенствовать себя, могут развиваться быстрее, чем люди успеют обеспечивать безопасность.
Anthropic признаёт обе стороны этого процесса. В документах к IPO компания отмечает, что уже использует ИИ в собственных исследованиях и разработке новых моделей. Однако такой подход может привести к тому, что возможности систем будут расти быстрее, чем способность разработчиков проверять их безопасность, надёжность и соответствие человеческим целям.
Anthropic сообщила, что в прошлом уже не сразу замечала значительные скачки возможностей своих моделей, а в будущем подобные ускорения могут оставаться незамеченными до тех пор, пока не произойдут. Более того, внутренние оценки и прогнозы будущих моделей указывают, что компания может в ближайшее время достичь установленного ею порога «резко ускоренного прогресса, обусловленного ИИ». При этом Anthropic подчёркивает, что ни одна из существующих моделей пока не признана соответствующей этому критерию.
В документах также говорится, что Anthropic не рассчитывает в обозримом будущем поручить Claude полностью автономное проектирование и создание следующих поколений передовых моделей — без человеческого контроля.

Источник Для просмотра ссылки Войди или Зарегистрируйся

Anthropic вплотную приблизилась к самосовершенствующемуся ИИ — и признала новые риски​


Anthropic накануне подала уточнённую форму S-1/A, в которой, помимо финансовых показателей, раскрыла ещё одну примечательную деталь. Компания находится на пороге создания модели искусственного интеллекта, способной к рекурсивному самосовершенствованию (Recursive Self-Improvement, RSI).
 Источник изображения: anthropic.com

Источник изображения: anthropic.com​

RSI — этап, на котором ИИ становится настолько эффективным в собственном обучении, что это приводит к резкому ускорению развития его возможностей. Для тех, кто опасается катастрофических последствий развития ИИ, RSI представляется точкой невозврата: ИИ обретает возможность усовершенствовать себя до такой степени, что выйдет из-под контроля и станет безразличным к ущербу, который может причинить в процессе достижения своих целей. Для энтузиастов RSI, напротив, представляет собой воплощение потенциала технологий — превращение ИИ в инструмент, способный обеспечить невероятный рост продуктивности, совершить научные открытия и ознаменоваться иными достижениями.
В Anthropic считают, что RSI несёт в себе как огромные возможности, так и серьёзные риски. Компания уже использует ИИ в исследованиях и разработке, отметила она, но предостерегла: «Использование ИИ для создания более совершенных систем ИИ может представлять значительную угрозу безопасности, особенно если это резко ускорит темпы прогресса. Это один из аспектов, учитывающийся в нашей „Политике ответственного масштабирования“, в которой изложены планы по мониторингу и снижению рисков по мере приближения к тому, что называется рекурсивным самосовершенствованием».


Обозначение RSI вошло в обиход относительно недавно и поначалу воспринималось как недостижимая цель — эффект, который будет крайне сложно реализовать на практике. Теперь же Anthropic указала его среди факторов риска. Она уже использовала ИИ в разработке новых моделей, «чьи качественные скачки в возможностях своевременно не были замечены»; а в ближайшем будущем, по её словам, может значительно ускорить прогресс с помощью ИИ.
«Более того, расширение использования систем ИИ для ускорения наших собственных исследований и разработки может привести к тому, что возможности наших моделей будут развиваться быстрее, чем наша способность разрабатывать, проверять и развёртывать соответствующие средства безопасности, согласования целей и защиты. В результате мы в прошлом уже упускали из виду и можем не заметить в будущем значительное ускорение темпов нашего развития до того момента, как оно уже случится. Например, наши внутренние оценки и прогнозы относительно будущих моделей, в отличие от текущих, указывают, что в скором времени мы можем достичь порога, который в нашей „Политике ответственного масштабирования“ определяется как „обусловленное ИИ значительное ускорение прогресса“. На данный момент ни одна из наших моделей не классифицируется как преодолевшая этот порог, и мы продолжаем анализировать соответствующие данные», — заявили в Anthropic.

Компания также не рассчитывает, что сможет в значительной мере полагаться на существующие ИИ-системы для «полностью автономного проектирования и создания последующих поколений передовых моделей без значимого контроля или понимания со стороны человека — даже если (и когда) это станет технически возможным». Есть мнение, что форма S-1 может выступать не только средством раскрытия информации, но и маркетинговым материалом. Тем не менее, за последний год ИИ Anthropic совершил колоссальный скачок в научной области; и если в компании считают высокой вероятность наступления RSI, то, возможно, имеет смысл отнестись к этому серьёзно.

Источник Для просмотра ссылки Войди или Зарегистрируйся

Китайская Tencent бросила вызов DeepSeek и Kimi — открытая ИИ-модель Hy4 умеет видеть и рассуждать​


Китайский технологический гигант Tencent Holdings представил флагманскую модель искусственного интеллекта Hy4. Она публикуется с открытыми весами и предлагает расширенные возможности ИИ-агентов, выступая основой для корпоративной платформы WorkBuddy.

 Источник изображения: tencent.ai

Источник изображения: tencent.ai​

Важнейшим нововведением Tencent Hy4 стала поддержка визуального восприятия — модель способна обрабатывать изображения, анализировать сложные графики и выполнять математические рассуждения на основе визуальных данных. С выходом новой модели линейка ИИ-решений компании стала «одной из наиболее мощных среди доступных сегодня моделей с открытыми весами». При этом Hy4 пока уступает передовым закрытым системам, особенно в решении сложных задач, таких как математические исследования, написание программного кода в рамках долгосрочных проектов, самостоятельное совершенствование и продвинутый визуальный анализ — ответы на вопросы по изображениям.
Размер Tencent Hy4 составляет 770 млрд параметров — в 2,6 раза больше, чем у предшествующей Hy3 с 295 млрд параметров. Следующее поколение модели, Hy5, будет ещё масштабнее, пообещал разработчик, и в ближайшее время появится облегчённый вариант Hy4 Flash, который поможет значительно снизить затраты на выполнение задач. Tencent подключила новую модель к платформе ИИ-агента WorkBuddy — по внутренним оценкам, она показала с этим инструментом средний результат в 83,18 балла с долей успешных решений 96,15 %.


Представленная в конце августа предварительная версия Hy4 на текущий момент занимает 23 место в мировом рейтинге WebDev на платформе Code Arena — бенчмарк оценивает большие языковые модели в режиме реального времени на основе практических задач по программированию. Значительное увеличение объёма обучающих данных и масштаба модели помогли Hy4 превзойти свою предыдущую версию в 12 категориях задач, включая автономное выполнение действий, написание программного кода и автоматизацию рабочих процессов. Она обошла Z.ai GLM-5.3 и DeepSeek-V4.1-Flash-1017, выступив наравне с Moonshot Kimi K3.1 Pro.

В процессе обучения Tencent ограничила возможности, связанные с хакерской деятельностью: из обучающей выборки исключили материалы, связанные с разработкой эксплойтов, обратным проектированием и тестированием на проникновение — «чтобы избежать усиления возможностей для проведения наступательных кибератак».

Источник Для просмотра ссылки Войди или Зарегистрируйся
 
Последнее редактирование:

Tesla замахнулась на 80-кратный прирост мощности ИИ-чипов и переименовала их в ускорители суперинтеллекта​


Tesla представила обновлённую дорожную карту выпуска ИИ-ускорителей, сменив их название на SI. Ожидается, что чипы шестого поколения SI6 обеспечат 80-кратный прирост вычислительной мощности, а система Dojo 3 также будет использоваться в космосе.
 Источник изображения: Tesla/Tom's Hardware

Источник изображения: Tesla/Tom's Hardware​

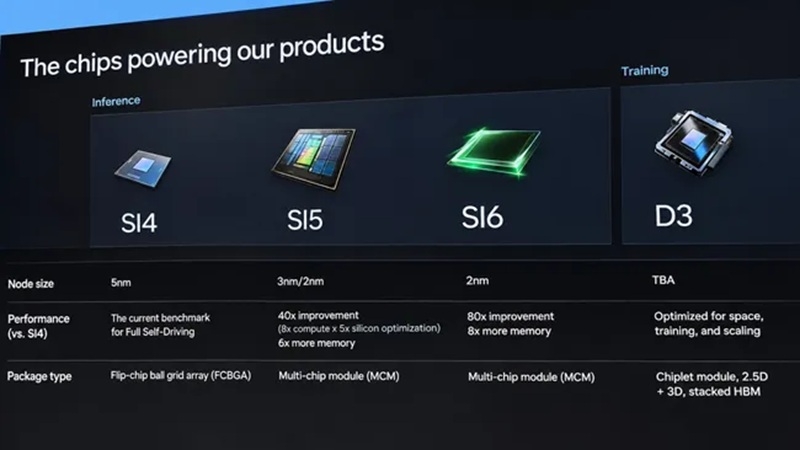
Согласно дорожной карте, ускоритель шестого поколения SI6 для инференса получит в 80 раз более высокую производительность по сравнению с чипом четвёртого поколения. А в ускорителе для обучения моделей Dojo 3 (D3) будет использоваться многочиплетная архитектура со стековой памятью HBM. Также компания сменила брендинг ускорителей: теперь они будут выпускаться под названием SI (Super Intelligence, «суперинтеллект»), которое заменит термин AI (искусственный интеллект). Ранее Илон Маск (Elon Musk) подтвердил, что по той же причине проект SpaceXAI будет переименован в SpaceXSI.
Dojo 3 (D3), как сообщается, объединяет технологии 2.5D- и 3D-компоновки со стековой памятью HBM, что означает значительный отход от первоначальной архитектуры Dojo D1 с использованием памяти SRAM. Вместе с тем данные о вычислительной мощности, объёме памяти, техпроцессе или сроках разработки D3 пока не сообщаются. Как ожидается, D3 будет оптимизирован для работы в космосе, что, вероятно, означает его радиационную стойкость.


Что касается SI6, то на данный момент известно, что он превышает по производительности по производительности SI4 (W4) в 80 раз, а объём памяти — в 8 раз. Речь идет о показателях в диапазоне 17 280–46 080 TOPS или 17,28–46,08 POPS — в зависимости от того, как измеряется производительность, отметил ресурс Tom's Hardware.
Используемый в современных автомобилях Tesla чип SI4 (HW4) производится Samsung Foundry по 7-нм техпроцессу. Как ожидается, чип пятого поколения SI5, который будут выпускать TSMC (3 нм) и Samsung Foundry (2 нм), получит 40-кратный прирост производительности по сравнению с HW4.
Компания Tesla уже заключила с Samsung Foundry соглашение о производстве ускорителей шестого поколения для инференса, которое будет действовать до 2033 года. Согласно представленным материалам, чипы SI6 будут изготавливаться с применением техпроцесса класса 2 нм.

При этом в планах Tesla не предусмотрено использование для производства чипа SI6 мощностей Intel (Terafab) и техпроцесса Intel 14A в 2030-х годах. Учитывая сроки выхода (2029–2030 годы) и обновлённую дорожную карту Samsung Foundry, речь, вероятно, идёт о техпроцессах SF2A (автомобильного класса), SF2P (с повышенной производительностью) или даже SF2Z, предположил Tom's Hardware.

Источник Для просмотра ссылки Войди или Зарегистрируйся

Китайский ИИ почти догнал секретную модель OpenAI во взломе сетей — и оказался дешевле​


Эксперимент, в ходе которого моделям искусственного интеллекта ставилась задача взломать имитированные сети, показал, что способности китайских нейросетей DeepSeek и Z.ai GLM практически не уступают самой продвинутой модели от OpenAI, которая даже не находится в открытом доступе.

​

Специализирующаяся на оценке систем ИИ компания Vals провела тестирование с целью установить, насколько успешно различные ИИ-модели справляются со сложными многоэтапными задачами по проникновению в имитированные корпоративные сети. В сфере кибервзломов закрытые системы больше не обладают явным преимуществом перед открытыми, гласят выводы компании. Другими словами, попытки разработчиков передовых ИИ-систем ограничить доступ к своим продуктам, чтобы замедлить распространение подобных возможностей, имеют всё меньше смысла.
В апреле Anthropic открыла ограниченный доступ к Claude Mythos Preview, чтобы выиграть время, прежде чем продвинутые инструменты для взлома станут общедоступными. Тогда глава отдела стресс-тестирования ИИ в компании Логан Грэм (Logan Graham) предупредил, что нужно готовиться жить в мире, где такие возможности станут широко доступными — через полгода, год или два. Его прогноз сбылся через семь месяцев.


Vals тестировала ИИ-модели в двух смоделированных сценариях, поставив перед ними ряд конкретных задач. Первый сценарий предполагал наличие корпоративной сети со входом через общедоступный сайт. Второй предполагал наличие двух корпоративных сетей, и требовалось взломать первую, чтобы получить доступ ко второй. Самой эффективной оказалась модель с ограниченным доступом в рамках проекта OpenAI Daybreak — она справилась с 81 % поставленных перед ней задач. Китайская открытая DeepSeek выполнила в среднем 73 % заданий, и в ряде задач обе показали одинаковые результаты.
Исследование продемонстрировало, насколько дешевле обходятся для подобных целей модели с открытыми весами: затраты на токены для проведения атаки с помощью GPT-6-Sol составили от $17 до $46, а в случае DeepSeek это были всего $2–3. Модели с открытыми весами, как правило обходятся дешевле, потому что запускаются на оборудовании пользователя; это создаёт и весомый стимул для тех, кто занимается киберзащитой — им тоже выгоднее использовать открытые, а не проприетарные модели.

ИИ помог повысить скорость и масштаб как обнаружения, так и устранения уязвимостей, и эксперты продолжают спорить о том, изменил ли ИИ фундаментальные основы и принципы киберзащиты. Другими словами, пока нет ясности, создаёт ли ИИ угрозу принципиально нового типа, или он просто усугубляет уже давно существующие проблемы безопасности. Киберпреступники действительно стали применять ИИ при атаках. При этом в большинстве случае они обходятся более старыми и менее мощными моделями; к тому же пользуются доступом и к закрытым — меры их защиты не всегда достаточно эффективны.

Источник Для просмотра ссылки Войди или Зарегистрируйся
 
Последнее редактирование:

Google открыла доступ к самой мощной ИИ-модели Gemini 4 Carbon​

ИИ предназначен для сложных задач программирования, научных исследований и кибербезопасности​


Компания Google открыла широкий доступ к своей новой ИИ-модели Gemini 4 Carbon. Изначально в конце октября ее представили ограниченному кругу компаний, специализирующихся на кибербезопасности. Теперь модель стала доступна разработчикам, корпоративным клиентам, ученым и обычным пользователям.
Google открыла доступ к самой мощной ИИ-модели Gemini 4 Carbon

Источник изображения: Google
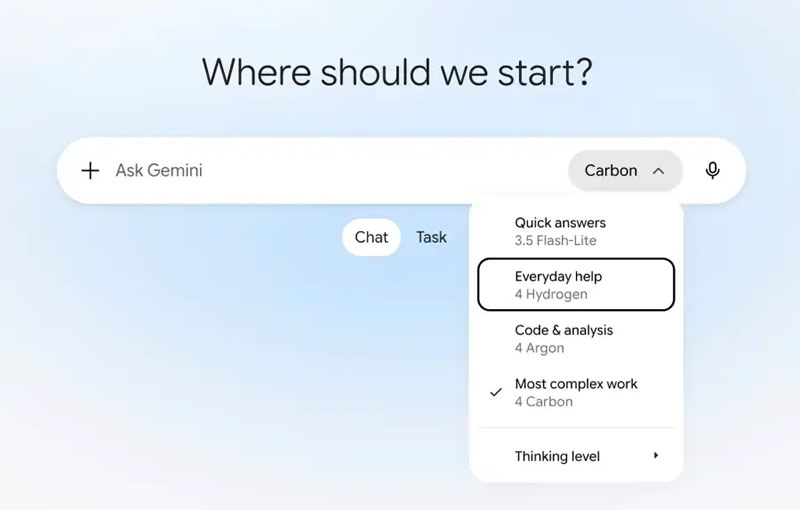
По данным компании, Carbon рассчитана на сложные задачи, требующие глубокого анализа и многоэтапных рассуждений. Среди основных направлений — разработка и отладка программного обеспечения, научные исследования, поиск уязвимостей и работа с большими массивами данных. При этом для большинства повседневных задач и стандартной разработки Google рекомендует использовать Gemini 4 Argon, которая работает быстрее и требует меньше ресурсов.
В ходе первых испытаний Carbon помогла специалистам обнаружить уязвимости нулевого дня. Также модель показала результаты в прогнозировании структуры белков, что может применяться при разработке лекарств. Google предоставит 10 тыс. ученых бесплатный доступ к ней на шесть месяцев для проведения исследований.
Gemini 4 Carbon уже доступна в Google AI Studio и Gemini для бизнеса. Подписчики Google AI Ultra также получат доступ к модели в приложении Gemini, поиске и платформе Antigravity. Разработчикам ее предлагают по той же начальной цене, что и Argon: $2 за миллион входных и $10 за миллион выходных токенов.

Источник Для просмотра ссылки Войди или Зарегистрируйся

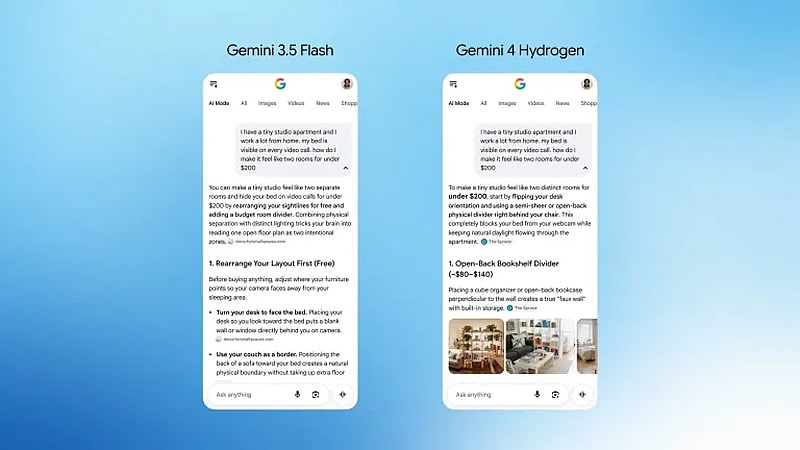
Google представила Gemini 4 Hydrogen — модель работает в 2,5 раза быстрее предшественницы и уже доступна всем​


Google представила новую ИИ-модель Gemini 4 Hydrogen для повседневной работы, программирования и выполнения задач с помощью автономных ИИ-агентов. Модель выполняет задания в 2,5 раза быстрее Gemini 3.8 Flash, меньше галлюцинирует и доступна для всех пользователей.

 Источник изображений: Google

Источник изображений: Google​

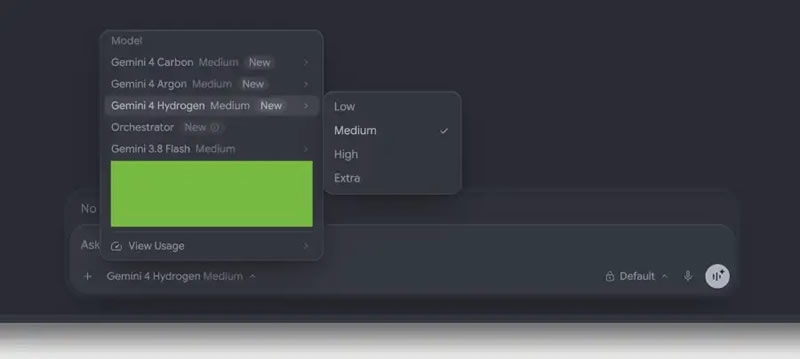
В отличие от Для просмотра ссылки Войди или Зарегистрируйся и Для просмотра ссылки Войди или Зарегистрируйся, ориентированных на сложные задачи, Hydrogen рассчитана на быстрое выполнение большого количества повседневных операций. Она поддерживает контекстное окно на 1 млн входных токенов и может генерировать до 1 млн выходных токенов. Пользователям доступны четыре уровня рассуждений: Low, Medium, High и XHigh, позволяющие выбирать баланс между скоростью работы и глубиной анализа.
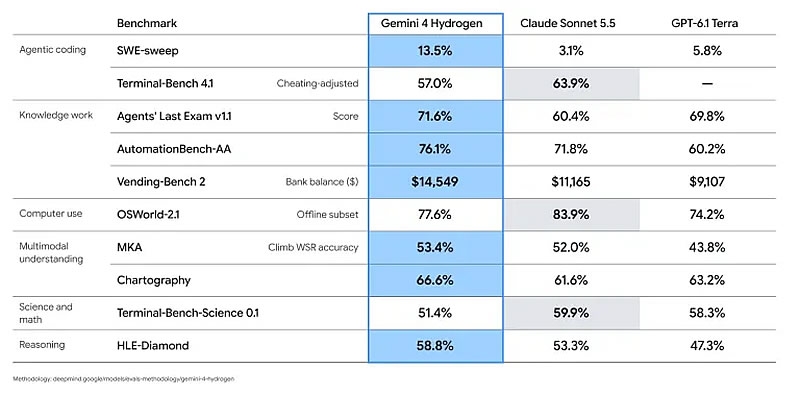
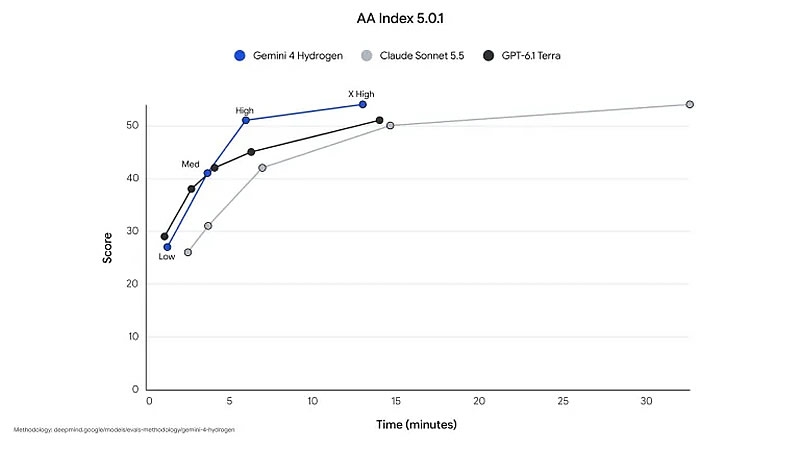
В тесте Terminal-Bench 4.1 модель набрала 57 % против 18,2 % у Gemini 3.8 Flash. В сводном бенчмарке LLM моделей Artificial Analysis Intelligence Index Hydrogen получила 51 балл на своём стандартном высоком уровне рассуждений, опередив Gemini 4 Argon с результатом 50 баллов. При использовании максимального уровня XHigh показатель достигает 54 баллов. В отдельных испытаниях также зафиксированы увеличение скорости работы в 2–2,8 раза и сокращение расхода токенов на 12–23 % относительно предыдущей модели.


Одновременно Google представила Orchestrator для агентной платформы Antigravity, который автоматически переключается между разными моделями в зависимости от характера задачи. Например, Gemini 4 Carbon может выступать координатором, распределять работу между агентами на базе Hydrogen и проверять их результаты. В тесте Terminal-Bench 4.0 Orchestrator показал результат, близкий к Carbon, но потребовал в среднем на 24 % меньше вычислительных ресурсов, завершив все задания на 19 % быстрее.
В приложении Gemini новая модель лучше следует инструкциям, сохраняет заданный стиль и формат ответов, а также эффективнее использует подключенные сервисы и инструменты.
В Google Search она улучшает понимание сложных запросов, формирует более наглядные ответы и предлагает расширенный набор ссылок.

Модель уже появилась в приложении Gemini и поисковой системе Google, а также доступна разработчикам и корпоративным клиентам. Стоимость использования через API составляет $1,50 за миллион входных и $7,50 за миллион выходных токенов. Модель распространяется по всему миру.

Источник Для просмотра ссылки Войди или Зарегистрируйся
 
Последнее редактирование:

SpaceX уволила 60 разработчиков Grok Imagine, оставив ИИ-генератор почти без команды​

Компания Илона Маска переключает ресурсы с создания видео и изображений на ИИ-программирование и автономных агентов​


SpaceX уволила 60 сотрудников, работавших над Grok Imagine. По данным The Information, сокращения прошли в течение последней недели в подразделении SpaceX Super Intelligence. После них поддерживать продукт осталась лишь небольшая группа специалистов. Сам сервис пока доступен пользователям, однако насколько активно компания намерена его развивать, теперь неясно.
Сокращение команды произошло на фоне смены приоритетов ИИ-подразделения SpaceX. В феврале 2026 года компания приобрела xAI в рамках сделки с оплатой акциями, оценившей разработчика Grok в $250 млрд. Затем, в августе, SpaceX завершила приобретение Anysphere — создателя ИИ-помощника для программирования Cursor. Сделка исходила из оценки компании в $60 млрд. Таким образом, под управлением SpaceX оказались сразу несколько направлений разработки ИИ, но теперь основной акцент, судя по кадровым решениям, смещается к программным инструментам.
Для просмотра ссылки Войди или Зарегистрируйся
Источник изображения: Grok Imagine

В отличие от генераторов изображений и видео, ИИ-помощники для программистов и автономные агенты могут выполнять конкретные рабочие задачи: писать и исправлять код, поддерживать программные проекты и проводить многоэтапные операции с минимальным участием человека. Для корпоративных заказчиков ценность таких инструментов проще измерить через экономию времени и повышение производительности. Одним из перспективных направлений может стать Grok Bot — универсальный ИИ-агент, о разработке которого ранее сообщалось в связи с Cursor.
Похожий пересмотр приоритетов произошёл и у OpenAI: в марте 2026 года компания объявила о прекращении работы над видеогенератором Sora. Теперь SpaceX сокращает большую часть команды Grok Imagine. Оба решения показывают, что даже крупные разработчики ИИ пересматривают инвестиции в генерацию видео, тогда как программирование и агенты становятся одним из главных направлений коммерческого развития. При этом SpaceX пока не объявляла о закрытии Grok Imagine: дальнейшая судьба сервиса остаётся открытой.

Источник Для просмотра ссылки Войди или Зарегистрируйся

Китай выпустил ИИ, который заставит OpenAI и Anthropic пересмотреть ценники​


Qwen4-Max обходит конкурентов в отдельных тестах, а генерация миллиона токенов обходится всего в $4,5.
image

Alibaba представила флагманскую нейросеть Qwen4-Max, которая в отдельных тестах обошла ведущие модели OpenAI и Anthropic. Новинка получила контекстное окно на миллион токенов, а стоимость её использования оказалась заметно ниже, чем у многих американских конкурентов.
Одним из главных достижений стал результат в Agents' Last Exam v1.1, где проверяют способность ИИ-агентов самостоятельно выполнять сложные многоэтапные задания. Qwen4-Max набрала 46,7%, опередив Claude Opus 5.5 с результатом 43,4% и GPT-6 Astra с 42,6%. По представленной Alibaba сравнительной таблице китайская разработка заняла первое место в испытании, однако превосходство в одном тесте ещё не означает лидерства по всем направлениям.
В программировании результаты оказались неоднозначными. В DeepSWE v1.1, где модели решают задачи разработки программного обеспечения, Qwen4-Max получила 75,7 балла, немного опередив Claude Opus 5.5 и Kimi K3.1. Зато в Terminal-Bench 4.0 китайская система набрала 48,5 балла против 59,6 у Claude Opus 5.5 и 67,2 у Kimi K3.1. В ProgramBench отставание также оказалось существенным, поэтому заявления о безоговорочной победе над конкурентами были бы преждевременными.
Главным преимуществом Alibaba может стать стоимость вычислений. Согласно международным тарифам для сингапурского региона, миллион входных токенов Qwen4-Max стоит $1,5, а миллион выходных обходится в $4,5. Для сравнения, Opus 5.5 тарифицируется по $4 и $20 соответственно, а GPT-6.1 Sol от OpenAI по $2 и $10. Таким образом, генерация ответа у Alibaba обходится более чем в четыре раза дешевле, чем у Opus 5.5, если сравнивать стандартные цены за одинаковое количество выходных токенов.

По сравнению с Qwen3.8-Max новая модель стала дешевле и по собственным тарифам Alibaba. В международном регионе цена миллиона входных токенов снизилась с $2 до $1,5, а выходных с $6 до $4,5. При повторном использовании сохранённого контекста действует дополнительная скидка. Обращение к уже закешированным данным обходится в $0,075 за миллион токенов, что особенно полезно приложениям, которые многократно работают с одними документами или инструкциями.
Разработчики также утверждают, что улучшили эффективность рассуждений. В испытании Terminal-Bench 4.0 Qwen4-Max расходовала примерно на 48–49% меньше токенов, чем предыдущее поколение, а в корпоративном тесте Work360 экономия составила 24–35% в зависимости от настроек. Средняя стоимость выполнения задания в Work360 снизилась с $4,43 до $1,67, или на 62%. Однако речь идёт о внутренних измерениях Alibaba, поэтому переносить полученную экономию на любые реальные задачи пока нельзя.
В основе Qwen4-Max лежит архитектура «смесь экспертов» (Mixture of Experts, MoE). Основная нейросеть содержит 2,4 трлн параметров, но при обработке каждого токена активирует только 71 млрд. Ещё 328 млрд параметров приходятся на механизм N-gram Embedding, помогающий обрабатывать повторяющиеся последовательности элементов текста. Благодаря выборочному использованию компонентов система может сохранять большую вычислительную мощность без необходимости задействовать всю модель при каждом запросе.
Инженеры Alibaba переработали механизм внимания, отвечающий за использование информации из контекста. Новая комбинация Gated DeltaNet и Qwen Sparse Attention позволяет сжимать историю обработки и выбирать наиболее значимые фрагменты длинного запроса. Дополнительный механизм Gated Residual управляет передачей информации между слоями нейросети. Подобная организация вычислений должна снижать нагрузку при работе с большими документами и продолжительными последовательностями действий.
Qwen4-Max поддерживает миллион токенов контекста, что позволяет передавать модели крупные программные проекты, объёмную документацию и множество связанных материалов. При этом максимальный размер входных данных в обычном режиме составляет 991 808 токенов, поскольку часть окна резервируется под ответ. Система принимает текст, изображения и видео, но генерирует текстовый результат. В режиме без углублённых рассуждений максимальная длина ответа достигает 131 072 токенов.
Помимо обычного диалога, новая модель умеет обращаться к внешним инструментам, искать информацию в интернете, выполнять последовательности команд и формировать структурированные ответы. Alibaba рассчитывает использовать Qwen4-Max для программирования, подготовки деловых документов, проектирования интерфейсов и автоматизации сложных профессиональных процессов. Поддержка интерфейсов, совместимых с OpenAI и Anthropic, позволяет разработчикам подключать нейросеть к существующим приложениям без полной переработки их программной архитектуры.
В демонстрационных проектах Alibaba показала создание компьютерных игр с использованием Unreal Engine, Unity и Godot, а также построение трёхмерных сцен в Blender. В промышленном примере с SANF и Pacific Union время подготовки программы для обработки одной детали якобы сократилось с 475 до 24 минут. Компания также продемонстрировала применение ИИ-агента в финансах, юриспруденции и научных исследованиях. Однако показатели относятся к отдельным сценариям, выбранным разработчиками, и пока не подтверждают сопоставимую производительность в других условиях.
Отдельное внимание команда уделила безопасности генерируемого кода. В испытании Last Secure Code Bench доля решений, успешно прошедших функциональные проверки и проверки безопасности на уровне отдельных функций, выросла с 22% у Qwen3.8-Max до 31,8% у нового поколения. Улучшение заметное, но даже по результатам разработчика большинство проверенных решений не соответствовали всем условиям. Поэтому использование Qwen4-Max для написания программ по-прежнему требует проверки кода, особенно в приложениях, обрабатывающих конфиденциальные данные.
Все опубликованные показатели пока следует воспринимать с учётом методики испытаний. Alibaba использовала собственные тестовые наборы и результаты сторонних рейтингов, причём условия запуска моделей могли различаться. В представленной компанией подборке Qwen4-Max лидирует в четырёх из шестнадцати сравнений, но уступает конкурентам в ряде задач программирования, анализа графиков и выполнения длинных последовательностей команд. Для оценки реального преимущества понадобятся независимые проверки с одинаковыми настройками и рабочими нагрузками.
Qwen4-Max стала доступна 16 ноября через QwenCloud API, Qwen Studio, QwenWork и среду разработки Qoder. Предварительную версию Alibaba открыла 11 ноября в рамках ограниченного тестирования, а теперь разработчики получили возможность оплачивать использование модели по количеству обработанных токенов. При этом компания пока не опубликовала веса самой Qwen4-Max для самостоятельного запуска. В дальнейшем Alibaba обещает выпустить более компактные модели семейства Qwen4 с открытыми весами, но сроки их появления не раскрывает.

Источник Для просмотра ссылки Войди или Зарегистрируйся

DeepSeek ввела лимиты для бесплатных пользователей после рекордного роста нагрузки​


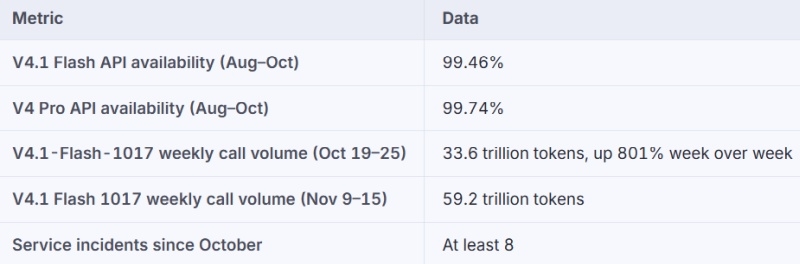
Компания DeepSeek ужесточила лимиты использования для бесплатных пользователей своего приложения и веб-версии. Отключено продолжение длительных диалогов, объём одного запроса ограничен 40 000 символов, введена суточная квота на количество сообщений. В компании объяснили это нехваткой вычислительных мощностей. За последнюю неделю число запросов к модели V4.1-Flash-1017 достигло рекордных 59,2 трлн токенов, что вывело модель на первое место в мире.

 Источник изображений: DeepSeek

Источник изображений: DeepSeek​

С октября было зафиксировано как минимум восемь сбоев в работе сервиса. Многие пользователи DeepSeek столкнулись с уведомлениями «недостаточно вычислительных мощностей» или «исчерпана квота на использование». Некоторые пользователи сообщают, что доступ к сервису ограничивается уже после двух часов непрерывного использования. Компания пока не предоставила чётких разъяснений относительно правил квотирования и не сообщила, когда ограничения будут сняты.
Судя по отзывам пользователей, нововведения включают три основных ограничения. Во-первых, стало невозможно продолжать длительные диалоги, в которых не было активности более семи дней (некоторые пользователи получили уведомление с предупреждением за 72 часа). Во-вторых, максимальный объем одного текстового запроса был снижен примерно до 40 000 символов. В-третьих, была введена суточная квота на общение: при её исчерпании появляется сообщение «сервер занят, квота на использование исчерпана».


Данные ограничения затрагивают преимущественно потребительскую версию приложения и веб-интерфейс. На API-интерфейс, используемый разработчиками, это не влияет, поскольку для него предусмотрены отдельные лимиты на количество одновременных запросов и действует модель оплаты по факту использования (pay-as-you-go).
Согласно статистике платформы-агрегатора API для больших языковых моделей OpenRouter, за неделю с 19 по 25 октября версия Для просмотра ссылки Войди или Зарегистрируйся (обновлённая DeepSeek 17 октября) заняла первое место: объем запросов достиг 33,6 трлн токенов, что на 801 % больше показателя предыдущей недели. На втором месте оказалась более ранняя версия, V4.1 Flash, с показателем 18 трлн токенов.
Примечательно, что в тот период все пять верхних строчек рейтинга заняли китайские большие языковые модели. К неделе с 9 по 15 ноября объем запросов к V4.1 Flash 1017 вырос ещё больше — до 59,2 трлн токенов, что позволило модели удержать мировое лидерство. Модель, запущенная 10 сентября, за неделю с 14 сентября набрала 15,8 трлн токенов. Таким образом, всего за два месяца объем вырос почти втрое, тогда как расширение вычислительных мощностей явно не поспевало за этим темпом.
Согласно официальной странице состояния сервисов DeepSeek, с октября произошло как минимум восемь инцидентов, затронувших веб-версию для конечных пользователей, диалоги в приложении, а также API для моделей V4 Pro и V4.1 Flash. В частности, 15 октября произошёл самый масштабный за месяц сбой, длившийся более четырёх часов. Он ограничил доступ как к пользовательскому интерфейсу, так и к API двух флагманских моделей — это был самый масштабный инцидент за месяц.
Введение ограничений не стало полной неожиданностью. 13 ноября DeepSeek официально открыла доступ к полноценному API, предоставляющему все возможности приложения — веб-поиск, «глубокое» (аналитическое) мышление, работу с файлами и ссылками, а также голосовой ввод. Кроме того, компания опубликовала исходный код интерфейса чата (chat-demo) по лицензии MIT. По заявлению разработчиков, это позволяет создать «полную копию приложения DeepSeek». Пользователи теоретически могут воспользоваться API для создания собственного сервиса, однако в этом случае вычислительные ресурсы перестанут быть бесплатными.
Для управления нагрузкой DeepSeek внедрила ряд мер: в частности, дифференцированные тарифы для API в зависимости от времени суток (в часы низкой нагрузки стоимость услуг вдвое ниже, что стимулирует разработчиков обращаться к системе в это время). Также установлены отдельные лимиты на количество одновременных подключений: для моделей deepseek-flash и v4-pro они составляют 2500 и 500 сессий соответственно, причём эти ресурсы полностью отделены от тех, что выделены для обычных пользователей приложения.
Для DeepSeek такие ограничения — способ перераспределения ресурсов: компания жертвует частью возможностей при работе с длинными контекстами, чтобы обеспечить стабильную работу сервиса для активных пользователей. В первую очередь это затрагивает задачи, требующие сверхдлинного контекста — например, обработку больших документов, анализ объёмных фрагментов программного кода или длительные творческие процессы. Ранее пользователи могли работать с такими задачами бесплатно.
Ранее в коде веб-интерфейса были обнаружены элементы логики управления квотами, что породило слухи о возможном запуске платной подписки для обычных пользователей. Однако детальный анализ показал, что в коде нет ни цен на тарифные планы, ни разделов для оформления подписки, ни платёжных инструментов, а упоминание «обновления» (upgrade) на деле относилось лишь к обновлению самой веб-версии сервиса.
Такой подход согласуется с позицией основателя DeepSeek Лян Вэньфэна (Liang Wenfeng). Он неоднократно подчёркивал, что долгосрочная цель компании — создание сильного искусственного интеллекта (AGI), а продукты для частных лиц и бизнеса — лишь «побочные результаты на пути к этой цели». Что касается ценообразования, Лян придерживается принципа: «никаких субсидий и никакой сверхприбыли». По его словам, сдерживающим фактором является нехватка вычислительных ресурсов, а не нежелание масштабироваться.
DeepSeek планирует построить в Уланчабе дата-центр гигаваттного масштаба, оснащённый как минимум 160 000 ИИ-чипов китайского производства. Ожидается, что весь кластер будет вводиться в эксплуатацию постепенно — в период с конца 2027 по начало 2028 года. В октябре DeepSeek завершила второй раунд финансирования на сумму 105,5 млрд юаней (около $15,9 млрд), в результате чего оценочная стоимость компании достигла 615,5 млрд юаней (около $92,5 млрд). Компания не подтвердила ни сумму инвестиций, ни цели их использования, однако на рынке преобладает мнение, что средства в первую очередь будут направлены на развитие вычислительной инфраструктуры.
Проблема нехватки вычислительных мощностей актуальна не только для DeepSeek. OpenAI заключила семилетнее соглашение о сотрудничестве в сфере вычислений с AWS, обязавшись инвестировать $38 млрд. Anthropic в проспекте к своему IPO раскрыла информацию о договорённости с Google на закупку вычислительных ресурсов на сумму не менее $114,5 млрд до июля 2033 года. Руководители ряда китайских технологических компаний также отмечали в ходе отчётов о финансовых результатах, что вычислительные мощности используются максимально интенсивно, а оборудование находится в дефиците.
Для всей отрасли это служит чётким сигналом: в условиях экспоненциального роста спроса на вычислительные ресурсы эпоха «безлимитного контекста» в бесплатных больших языковых моделях подходит к концу. Рано или поздно расходы на вычисления в той или иной форме лягут на плечи пользователей. То, как китайские разработчики больших моделей будут находить баланс между стремлением нарастить объём запросов и ограниченными вычислительными мощностями, станет ключевым фактором конкуренции на следующем этапе развития рынка.

Теперь рынок ожидает ответа на вопрос: запустит ли DeepSeek платный тариф для частных пользователей? На данный момент в компании лишь отмечают, что её существующий диалоговый продукт — это «всего лишь относительно базовая форма», не называя при этом никаких сроков. Балансируя между прозрачностью правил и качеством пользовательского опыта, компания сталкивается со своим первым публичным испытанием на пути к коммерциализации.

Источник Для просмотра ссылки Войди или Зарегистрируйся

Alibaba представила Qwen4-Max — флагманскую ИИ-модель с 2,4 трлн параметров и запретом на кибератаки​


Компания Alibaba представила свою новую флагманскую ИИ-модель Qwen4-Max. Алгоритм с 2,4 трлн параметров в процессе работы задействует лишь 71 млрд параметров на токен, а также поддерживает обработку изображений. В дополнение к этому Alibaba представила специальные наборы данных для дополнительного обучения и доработки, которые позволяют снизить риски в области химического, биологического, радиологического и ядерного оружия.
 Источник изображений: qwen.ai

Источник изображений: qwen.ai​

Ещё одна особенность: строгие ограничения в области кибербезопасности. Вероятно, за счёт этого Alibaba пытается балансировать между безопасностью и сохраняющейся приверженностью открытому исходному коду на фоне растущей по всему миру обеспокоенности по поводу кибератак с применением ИИ. Особое внимание к обеспечению безопасности отражает растущее внимание к этому вопросу во всей ИИ-индустрии Китая. В сообщении Alibaba отмечено, что компания намеренно отфильтровала обучающие данные, удалив информацию, которая могла использоваться для «наступательных» действий в сфере кибербезопасности, но сохранив полезные возможности для обороны, например, для поиска уязвимостей.
Для просмотра ссылки Войди или Зарегистрируйся​
Alibaba подчеркнула достижения Qwen4-Max в научных исследованиях. Речь в том числе о непрерывном 48-часовом исследовании, в ходе которого была открыта и экспериментально подтверждена молекула-хладагент для полупроводниковой продукции нового поколения, а также автономном исследовании болезни Альцгеймера. Хотя Qwen4-Max останется закрытой моделью, разработчик подтвердил, что в скором времени будут доступны версии Qwen4 меньшего размера с открытыми весами.


Для просмотра ссылки Войди или Зарегистрируйся​

Как уже было сказано, Qwen4-Max располагает 2,4 трлн параметров, как и предыдущая Qwen3.8-Max. Однако новая ИИ-модель активирует только 71 млрд параметров на токен, что на 25 % меньше по сравнению с аналогичным показателем предыдущей версии алгоритма. Таким образом, алгоритм обеспечивает высокие способности к рассуждению, одновременно снижая затраты на инференс. По данным Alibaba, средняя стоимость выполнения одной задачи в Work360, внутреннем бенчмарке для оценки производительности моделей в разных задачах, снизилась на 60 %. Qwen4-Max имеет контекстное окно на 1 млн токенов. Стоимость кэшированного ввода составляет $0,075 за 1 млн токенов. Цена API составляет $1,5 за 1 млн входных и $4,5 за 1 млн выходных токенов.

Источник Для просмотра ссылки Войди или Зарегистрируйся
 
Последнее редактирование:
Назад
Сверху